Cómo se combina la IA con otras tecnologías médicas: cómo se entrenan modelos de IA con datos médicos
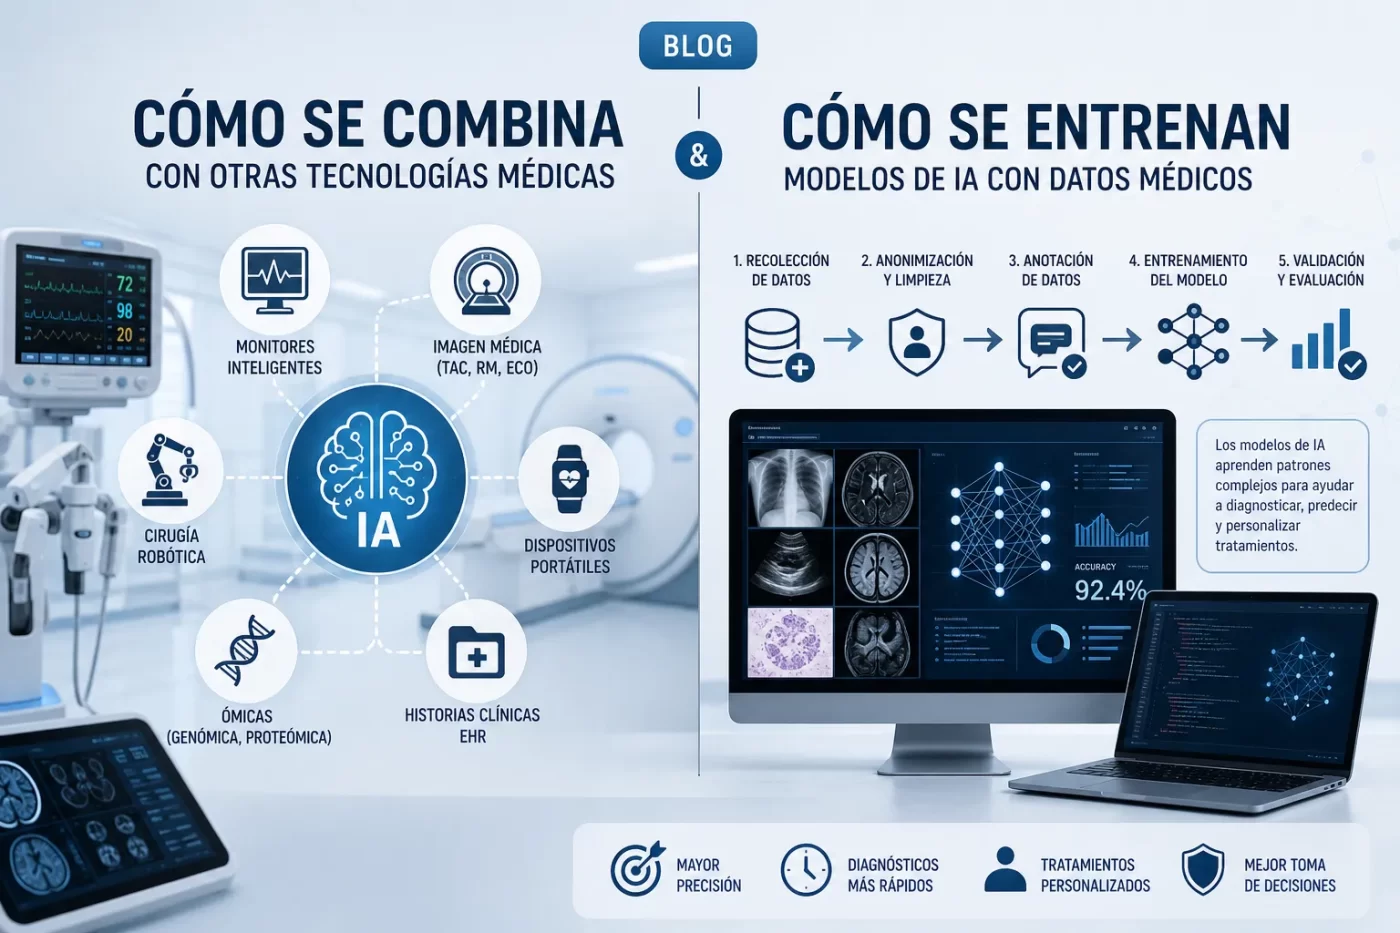
Cómo se combina con otras tecnologías médicas: integración de IA con imagenología, wearables y registros electrónicos
La integración de la IA con la imagenología permite acelerar y estandarizar la interpretación de estudios mediante algoritmos de detección, segmentación y cuantificación que se comunican con sistemas PACS y cumplen con formatos como DICOM. Estos flujos combinan el procesamiento automático de imágenes con la validación por especialistas, optimando tiempos de informe y facilitando búsquedas basadas en características de imagen para apoyo diagnóstico.
En el caso de los wearables, la IA procesa señales continuas (frecuencia cardíaca, actividad, oxigenación) para identificar patrones, anomalías y tendencias que generan alertas en tiempo real y recomendaciones personalizadas. La conexión segura de dispositivos al ecosistema clínico y al almacenamiento en la nube permite que estos datos en tiempo real se integren con historiales clínicos y alimenten modelos predictivos sinérgicos.
La unión con los registros electrónicos (EHR) se basa en la interoperabilidad y estándares como FHIR/HL7 para consolidar imágenes, datos de wearables y resultados analíticos en un único flujo clínico. Esta integración habilita soporte a la decisión clínica, análisis poblacionales y mejora de la continuidad asistencial, siempre considerando gobernanza de datos, calidad, validación clínica y protección de la privacidad.
Cómo se entrenan modelos de IA con datos médicos: guía paso a paso desde la recopilación hasta la validación
Entrenar modelos de IA con datos médicos sigue un flujo ordenado que va desde la recopilación hasta la validación, y cada etapa exige controles de calidad y cumplimiento normativo. Desde el inicio se debe definir el objetivo clínico y las métricas relevantes, además de gestionar consentimientos, anonimización y gobernanza de datos para cumplir con normativas como GDPR o HIPAA según la jurisdicción. La trazabilidad de las fuentes y metadatos es clave para reproducibilidad y auditoría.
Pasos principales
- Recopilación: obtención de datos clínicos y metadatos, consentimiento y evaluación de sesgos.
- Preprocesamiento: anonimización, limpieza, normalización y control de calidad.
- Anotación: etiquetado por expertos, definición de criterios y revisión interobservador.
- Entrenamiento: partición de datos, selección de arquitectura y ajuste de hiperparámetros.
- Validación: evaluación interna, validación externa y validación clínica/registro.
En la fase de preprocesamiento y anotación se corrigen errores, se mitigan sesgos y se decide la estrategia de partición (entrenamiento/validación/prueba) para evitar fuga de información. La calidad de las etiquetas y la documentación de los pipelines (versionado de datos y código) son determinantes para resultados fiables; también se emplean técnicas como aumentación y balanceo cuando corresponde.
Durante el entrenamiento se aplican validación cruzada y búsqueda de hiperparámetros, priorizando métricas clínicas relevantes (por ejemplo, sensibilidad, especificidad, AUC) según el caso de uso. La validación externa y los estudios clínicos confirman la generalizabilidad; tras el despliegue se debe monitorizar el rendimiento, detectar deriva del modelo y mantener documentación y planes de actualización para asegurar seguridad y cumplimiento continuo.
Interoperabilidad y flujo de trabajo: claves para combinar IA con dispositivos clínicos y sistemas hospitalarios
La interoperabilidad es la base para integrar la inteligencia artificial con dispositivos clínicos y los sistemas hospitalarios: sin estándares y modelos de datos compartidos, los algoritmos no pueden acceder ni contextualizar la información clínica. Implementaciones basadas en estándares como HL7/FHIR, DICOM para imágenes y terminologías normalizadas (SNOMED, LOINC) facilitan el intercambio estructurado entre sensores, monitores bedside y el EHR, mientras que APIs y capas de middleware permiten orquestar flujos de datos entre componentes heterogéneos.
Desde el punto de vista técnico, combinar IA con dispositivos exige resolver retos de conectividad en tiempo real, latencia y procesamiento en el edge frente a la nube, así como garantizar autenticación, cifrado y trazabilidad de los mensajes. La interoperabilidad semántica y el mapeo consistente de conceptos clínicos son críticos para que los modelos consuman datos fiables; por eso la validación, pruebas de integración y la monitorización continua del rendimiento y la calidad de datos son pasos imprescindibles antes del despliegue.
En términos de flujo de trabajo clínico, la integración debe priorizar la usabilidad y minimizar la carga sobre el personal: las recomendaciones de IA deben llegar contextualizadas dentro del EHR, con alertas alineadas a procesos existentes y opciones de revisión por el profesional (human-in-the-loop). La adopción requiere gobernanza de datos, políticas de consentimiento, formación, y ciclos de retroalimentación que permitan ajustar tanto modelos como conexiones de dispositivos conforme cambian protocolos y necesidades asistenciales.
Privacidad, calidad de datos y cumplimiento: retos y buenas prácticas al entrenar modelos de IA con datos médicos
Privacidad: al entrenar modelos de IA con datos médicos es imprescindible aplicar técnicas de anonimización y seudonimización, limitar el acceso mediante controles de identidad y cifrado en tránsito y reposo. El respeto al consentimiento informado y la minimización de datos reducen riesgos de reidentificación; además, mantener registros de acceso y auditorías facilita la trazabilidad y respuesta ante incidencias de privacidad.
Buenas prácticas para calidad de datos
- Curación y limpieza: eliminar entradas duplicadas, corregir errores y normalizar formatos para mejorar la calidad de entrenamiento.
- Etiquetado consistente: utilizar protocolos de anotación estandarizados y validación interanotador para reducir sesgos y ruido.
- Representatividad y equilibrio: asegurar muestras diversas y documentar limitaciones demográficas o de origen de los datos.
- Evaluación continua: establecer métricas de calidad y pipelines de monitorización para detectar deriva y degradación del modelo.
Cumplimiento normativo: cumplir marcos como GDPR, HIPAA y normativas locales exige políticas de gobernanza de datos, evaluaciones de impacto de privacidad y contratos claros con proveedores de servicios. La documentación detallada de linaje de datos, procedimientos de seguridad y validación clínica del modelo es clave para auditorías y para demostrar que el desarrollo del modelo sigue prácticas de responsabilidad, transparencia y mitigación de sesgos.
Casos prácticos y resultados: ejemplos reales de cómo se combina la IA con otras tecnologías médicas y cómo se entrenaron los modelos
En radiología y patología digital, la combinación de IA con tecnologías de imagen (TC, RM y escáneres de portaobjetos) ha permitido desarrollar modelos que asisten en la detección y cuantificación de lesiones; en monitorización, la fusión de IA con dispositivos wearables y señales fisiológicas facilita la detección temprana de eventos cardiacos o cambios metabólicos, y en cirugía la integración de algoritmos con sistemas de navegación o robots apoya la planificación y el control intraoperatorio. Estos casos prácticos se centran en integrar datos multimodales (imagen, señales, historia clínica) para ofrecer decisiones clínicas más informadas, sin sustituir al profesional.
Los modelos se entrenan generalmente con grandes conjuntos de datos anotados por especialistas: imágenes y registros etiquetados por radiólogos, patólogos o cardiólogos, y con esquemas de división multicéntrica para evitar sesgos. Se emplean técnicas como augmentación de datos, transfer learning y arquitecturas profundas (p. ej. redes convolucionales y modelos multimodales) para aprender representaciones robustas; además, es habitual realizar validación interna, validación externa en cohortes independientes y pruebas prospectivas antes de la implantación clínica.
Los resultados reportados en la literatura muestran mejoras en sensibilidad y especificidad para tareas concretas, reducción de tiempos de revisión y apoyo en la priorización de casos, así como mayor reproducibilidad en cuantificaciones automatizadas. No obstante, la eficacia final depende de la calidad y representatividad de los datos de entrenamiento, de la validación clínica y de la implementación regulatoria y operativa en cada institución.