Cómo se mide el rendimiento de modelos de IA con datos médicos: métricas, validación y buenas prácticas
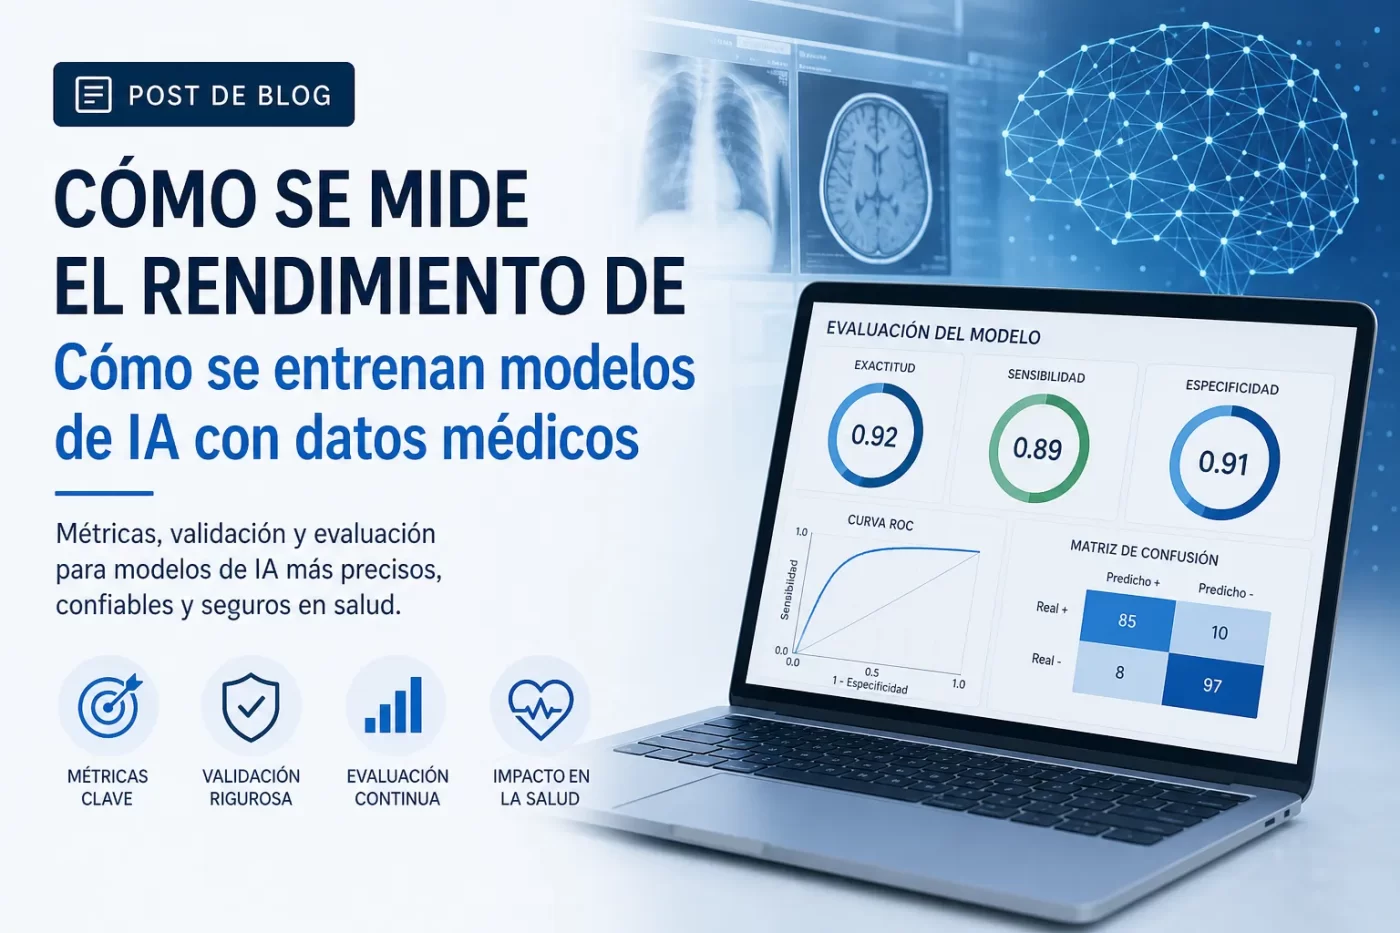
¿Cómo se mide el rendimiento de modelos de IA entrenados con datos médicos? Métricas clave y su interpretación
Para evaluar modelos de IA entrenados con datos médicos se parte de la matriz de confusión (verdaderos positivos, falsos positivos, verdaderos negativos, falsos negativos), de la que se derivan métricas fundamentales como la sensibilidad (recall) —capacidad para detectar casos enfermos— y la especificidad —capacidad para identificar sanos—. Otras métricas derivadas son la precisión (valor predictivo positivo, PPV) y el valor predictivo negativo (NPV); es importante destacar que PPV y NPV varían con la prevalencia de la condición en la población evaluada.
Para medir discriminación global se usan indicadores como el AUC-ROC (área bajo la curva ROC) que resume la capacidad del modelo para separar casos y controles a distintos umbrales, y el AUCPR (área bajo la curva precisión-recall) que suele ser más informativo en problemas con desequilibrio de clases. El F1-score combina precisión y recall en una única medida y puede ser útil cuando interesa equilibrar ambos errores. La exactitud (accuracy) puede ser engañosa en datos desbalanceados, por lo que es recomendable reportar múltiples métricas y analizar el efecto del umbral de decisión en la sensibilidad/especificidad.
La calibración es crítica en medicina: curvas de calibración y el Brier score verifican si las probabilidades predichas corresponden a riesgos observados, algo esencial para decisiones clínicas basadas en probabilidad. Además de intervalos de confianza y pruebas estadísticas para las métricas, la validación externa y la validación cruzada robusta son obligatorias para evaluar generalizabilidad; herramientas como el análisis de coste-beneficio o la decision curve analysis ayudan a interpretar la utilidad clínica real según diferentes umbrales y prevalencias.
Cómo se entrenan modelos de IA con datos médicos: limpieza, etiquetado y partición de datos para una evaluación fiable
La calidad de los modelos de IA en salud depende directamente de la preparación de los datos: una adecuada limpieza, un etiquetado riguroso y una partición cuidadosa son imprescindibles para una evaluación fiable. Antes de entrenar, los datos deben desidentificarse y normalizarse para cumplir con regulación y facilitar el aprendizaje automático, reduciendo ruido que pueda introducir sesgos en los resultados.
La limpieza abarca la gestión de valores faltantes, la corrección de errores de entrada, la normalización de unidades y la detección/eliminación de outliers que no correspondan a la realidad clínica. En datos no estructurados (texto clínico, imágenes) se requiere preprocesamiento específico —p. ej. segmentación de imágenes o limpieza de notas clínicas— manteniendo trazabilidad de los cambios para auditoría y reproducibilidad.
El etiquetado exige protocolos claros, anotadores formados y métricas de calidad como la concordancia inter-evaluador; el uso de ontologías y formatos estandarizados reduce ambigüedad. Es clave documentar criterios de inclusión/exclusión y el proceso de consenso para etiquetas difíciles, así como cuantificar el ruido de etiqueta y aplicar revisiones o etiquetado por múltiples expertos cuando sea necesario.
Para una evaluación fiable, la partición de datos debe evitar la fuga de datos y reflejar la distribución clínica real: separación por paciente (no por muestra), estratificación por clases relevantes y consideración de divisiones temporales para modelos predictivos. Buenas prácticas incluyen:
- Conjuntos train/validation/test independientes y, si es posible, validación externa.
- Estratificación para clases minoritarias y splits por paciente para evitar correlaciones.
- Uso de cross-validation solo en el conjunto de entrenamiento y evaluación final en test sin tunear.
Métricas esenciales: precisión, sensibilidad, especificidad, AUC y F1 para medir rendimiento en IA médica
Métricas clave y su rol en IA médica
En aplicaciones clínicas, las métricas cuantifican aspectos distintos del rendimiento: precisión (accuracy) mide la proporción de predicciones correctas totales, pero puede ser engañosa en conjuntos con clases desbalanceadas; por ello no debería usarse sola. Sensibilidad (recall) indica la capacidad del modelo para detectar casos positivos reales —crítica en cribados y detección precoz—, mientras que especificidad refleja la capacidad para identificar correctamente los negativos, importante para evitar falsos positivos y sobretratamiento.
El compromiso entre sensibilidad y especificidad depende del objetivo clínico y del coste de errores. Para evaluar rendimiento global independiente del umbral, se utiliza la AUC (área bajo la curva ROC), que resume la capacidad del modelo para discriminar entre clases a lo largo de distintos umbrales. AUC facilita la comparación entre modelos cuando la elección del umbral aún no está definida o cuando se exploran trade-offs operativos.
Cuando las clases están desbalanceadas o cuando interesan por igual los falsos positivos y negativos, el F1 score —la media armónica entre precisión y sensibilidad— ofrece una medida equilibrada que penaliza fuertemente grandes desequilibrios entre ambas. En la práctica clínica es habitual informar varias de estas métricas (
- Precisión: visión global del acierto
- Sensibilidad: detección de casos
- Especificidad: control de falsos positivos
- AUC: discriminación independiente del umbral
- F1: balance entre precisión y sensibilidad
) para una evaluación robusta del sistema de IA.
Validación externa y evaluación clínica: cómo validar y medir el rendimiento real de modelos médicos
Validación externa y evaluación clínica son pasos imprescindibles para comprobar la generalizabilidad y seguridad de modelos médicos desarrollados con datos internos. Mientras la validación interna (p. ej., cross-validation) mide rendimiento dentro del mismo conjunto de entrenamiento, la validación externa utiliza cohortes independientes y heterogéneas para identificar sesgos por procedencia de datos, diferencias en la adquisición de imágenes o variaciones demográficas. Un enfoque riguroso verifica tanto la discriminación como la calibración del modelo y documenta fallos en subgrupos clínicos relevantes.
Pasos y métricas clave
Para validar y medir rendimiento real se recomiendan prácticas estándar:
- Evaluación en datasets externos: usar hospitales, regiones o equipos diferentes al de entrenamiento.
- Métricas de desempeño: AUROC/AUPRC para discriminación, curva de calibración y Brier score para calibración.
- Análisis por subgrupos: rendimiento por edad, sexo, comorbilidades y etnia para detectar disparidades.
- Evaluación clínica: estudios prospectivos, ensayos controlados o estudios de implementación que midan impacto en decisiones clínicas y resultados de salud.
Medir el rendimiento en el mundo real requiere además monitoreo continuo post-implementación para detectar deriva del modelo y reevaluaciones periódicas con datos actualizados. Herramientas como análisis de impacto en variables clínicas, tasas de falsos positivos/negativos en la práctica, y métricas de utilidad clínica (p. ej., número necesario a tratar o decisión basada en umbrales) permiten traducir métricas técnicas a consecuencias clínicas. Finalmente, la documentación transparente de cohorts, protocolo de validación y reproducibilidad facilita la revisión regulatoria y la adopción segura en entornos asistenciales.
Mejores prácticas, sesgos y cumplimiento normativo al medir el rendimiento de IA con datos médicos
Mejores prácticas al medir el rendimiento de IA con datos médicos incluyen priorizar la calidad y representatividad de los datos, definir métricas clínicamente relevantes (sensibilidad, especificidad, AUC u otras según el caso) y garantizar replicabilidad mediante conjuntos de entrenamiento, validación y prueba bien separados. Es esencial documentar el flujo de datos, las transformaciones y las decisiones de diseño del modelo para facilitar auditorías y evaluaciones independientes, así como involucrar experTos clínicos desde la definición del problema hasta la validación final para asegurar que las métricas reflejen impacto real en la atención.
Mitigación de sesgos
- Analizar y reportar la composición demográfica y clínica de los conjuntos de datos para detectar subrepresentación.
- Realizar evaluaciones estratificadas por sexo, edad, raza/etnia y comorbilidades para identificar diferencias de rendimiento.
- Aplicar técnicas de reponderación, muestreo y ajuste de etiquetas cuando proceda, y validar con cohortes externas independientes.
- Implementar monitorización continua post‑despliegue y mecanismos de retroalimentación clínica para corregir sesgos emergentes.
Estas prácticas ayudan a reducir fuentes comunes de sesgo como muestreo no representativo, sesgo de etiqueta o diferencias en adquisición de datos.
El cumplimiento normativo exige controles de privacidad (p. ej., consentimiento informado, desidentificación y gobernanza de acceso), trazabilidad y documentación técnica que faciliten evaluaciones regulatorias y auditorías. Además de adherirse a marcos legales aplicables (por ejemplo, GDPR o HIPAA, según jurisdicción), conviene seguir estándares y guías de validación clínica, mantener registros de validación y desempeño, y establecer procesos de gestión de riesgos y vigilancia post‑mercado para garantizar seguridad y eficacia continuas.


