Impacto de la IA en la medicina personalizada: cómo se entrenan modelos con datos médicos
Impacto de la IA en la medicina personalizada: beneficios clínicos y perspectivas
La integración de la IA en la medicina personalizada está permitiendo correlacionar grandes volúmenes de datos —genómica, proteómica, imágenes médicas y registros electrónicos de salud— para identificar patrones clínicos que antes eran invisibles. Estas capacidades facilitan modelos de predicción que enriquecen la estratificación de riesgo y la caracterización de subgrupos de pacientes, mejorando la precisión del diagnóstico y la selección de terapias basadas en el perfil individual.
En el entorno clínico, los beneficios incluyen mayor sensibilidad y especificidad en el diagnóstico por imagen y en la interpretación de paneles genómicos, optimización del tratamiento personalizado mediante recomendaciones de fármacos y dosis ajustadas, y monitoreo remoto con detección temprana de descompensaciones. La IA también acelera la identificación de biomarcadores y la revisión automatizada de historiales, lo que reduce tiempos en la toma de decisiones y puede disminuir eventos adversos al personalizar las intervenciones.
De cara a las perspectivas, la IA impulsa nuevas vías en el diseño de ensayos clínicos adaptativos, la generación de evidencia del mundo real y la identificación de posibles candidatos para terapias dirigidas. No obstante, su adopción sostenida depende de la validación clínica robusta, la explicabilidad de los modelos y la interoperabilidad con sistemas sanitarios; aspectos fundamentales para que las ganancias en precisión se traduzcan en mejoras medibles en resultados de salud.
Cómo se entrenan modelos de IA con datos médicos: guía paso a paso
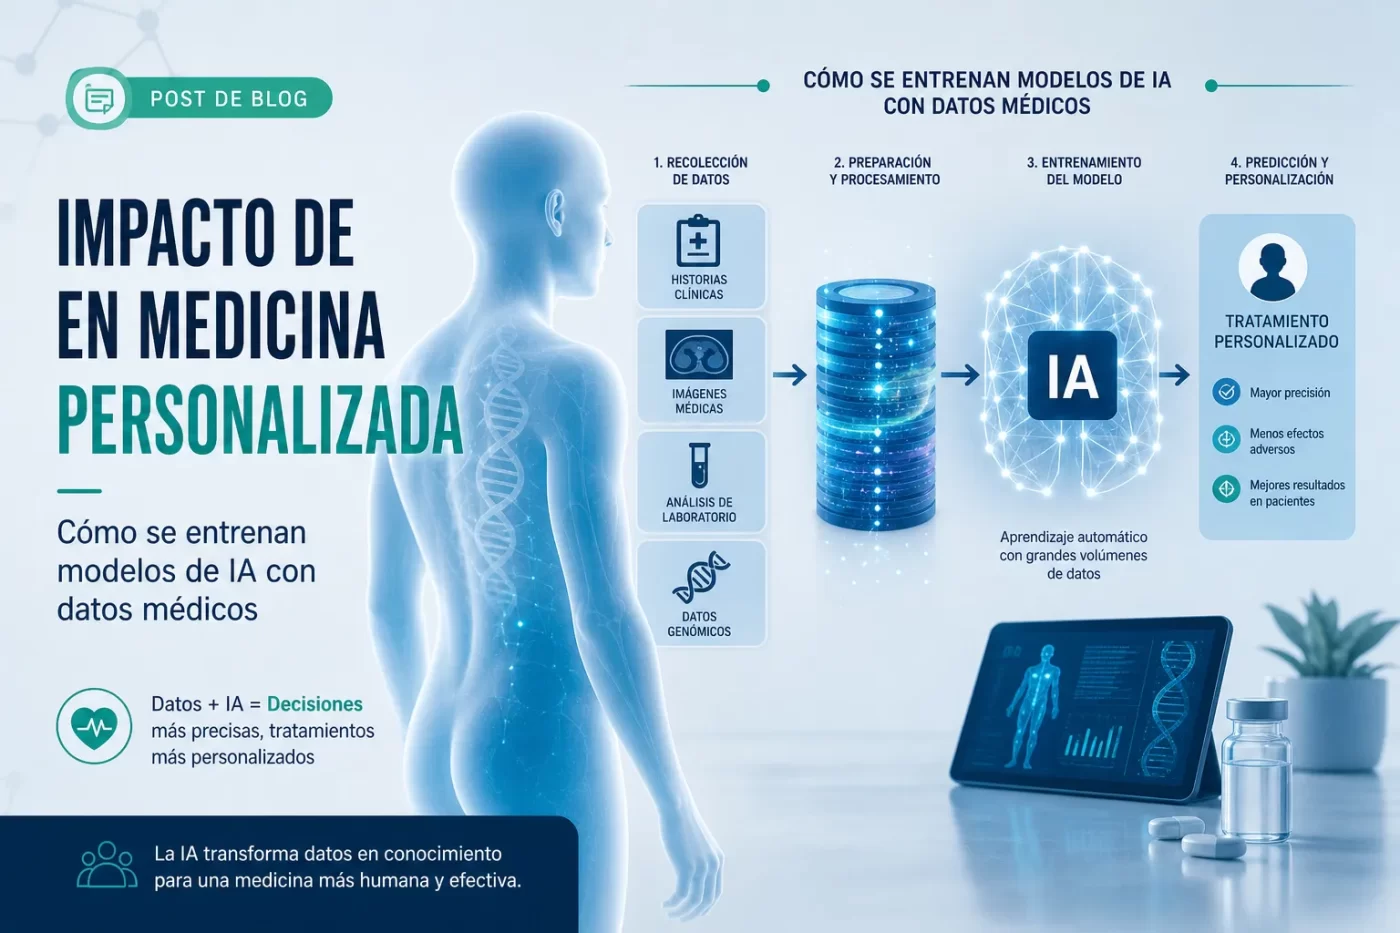
La primera fase para entrenar modelos de IA con datos médicos es asegurar la calidad y la legalidad de los datos: recolección con consentimiento o autorización ética, desidentificación, control de acceso y cumplimiento de normativas (por ejemplo, GDPR o HIPAA). Es esencial documentar fuentes, formatos (imágenes DICOM, registros electrónicos, secuencias genómicas) y posibles sesgos en la población para orientar el muestreo y la representatividad del conjunto de entrenamiento.
Pasos operativos típicos incluyen:
- Anotación y curación: etiquetado por expertos clínicos y revisión interobservador para establecer referencias fiables.
- Preprocesamiento: normalización, segmentación, aumento de datos y harmonización entre centros para reducir variabilidad técnica.
- División del conjunto: separación clara en conjuntos de entrenamiento, validación y prueba, y uso de validación cruzada cuando procede.
- Entrenamiento y ajuste: selección de arquitectura (redes convolucionales, transformadores, modelos tabulares), función de pérdida, optimizador y ajuste de hiperparámetros con monitorización de overfitting.
- Evaluación: métricas relevantes (sensibilidad, especificidad, AUC, calibración) y pruebas de robustez frente a subgrupos clínicos.
Antes del despliegue clínico es imprescindible la validación externa y, cuando proceda, ensayos prospectivos o revisiones por pares para verificar la utilidad clínica. También se recomiendan estrategias de privacidad como aprendizaje federado o datos sintéticos, junto con planes de monitorización continua, gestión de versiones, explicabilidad y auditoría para mantener seguridad, rendimiento y cumplimiento durante el ciclo de vida del modelo.
Tipos de datos médicos para entrenar IA: historias clínicas, imágenes, genómica y wearables
Para entrenar modelos de IA en salud se requieren principalmente cuatro tipos de datos médicos: historias clínicas, imágenes médicas, datos genómicos y registros de wearables. Cada categoría aporta información distinta —estructurada y no estructurada— y suele combinarse en enfoques multimodales para mejorar la predicción y la interpretación clínica. La disponibilidad de grandes volúmenes, la calidad de las anotaciones y el respeto a la privacidad son factores determinantes para que estos datos sean útiles en tareas de clasificación, segmentación, predicción o descubrimiento de patrones.
Principales fuentes
- Historias clínicas: registros electrónicos (EHR) que incluyen notas de médicos, diagnósticos codificados (ICD), resultados de laboratorio y medicamentos; suelen requerir normalización, extracción de características y anonimización antes del entrenamiento.
- Imágenes médicas: radiografías, TC, RM y ecografías en formatos como DICOM; necesitan etiquetado, segmentación y protocolos de calidad para entrenar modelos de detección y diagnóstico por imágenes.
- Genómica: secuencias, variantes y archivos VCF que aportan información molecular; su integración con fenotipos clínicos exige grandes volúmenes y pipelines de procesamiento específicos.
- Wearables: datos de sensores (frecuencia cardiaca, actividad, sueño) en series temporales; aportan monitorización continua y requieren manejo de ruido, sincronización y muestreo irregular.
Los retos comunes al preparar estos datos para IA incluyen la anotación experta, la estandarización (formatos interoperables), la representación demográfica equilibrada y las medidas de privacidad como la desidentificación y el consentimiento informado. Además, la heterogeneidad entre fuentes (estructurada vs. no estructurada, imágenes vs. secuencias temporales) obliga a diseñar pipelines de preprocesado y estrategias de fusión multimodal adecuadas para obtener modelos clínicamente robustos.
Mejores prácticas técnicas: preprocesamiento, etiquetado, validación y evaluación de modelos
Preprocesamiento
El preprocesamiento es clave para la calidad del modelo: incluye limpieza de datos (eliminar duplicados, corregir outliers), imputación de valores faltantes, y transformación de variables (normalización/estandarización y codificación de categóricas). Para texto y series temporales hay pasos específicos como tokenización, lematización y manejo de ventanas temporales. Implementa pipelines reproducibles y control de versiones de datos, y considera técnicas de balanceo de clases (resampling, SMOTE) para evitar sesgos en el entrenamiento.
- Validación de esquemas y tipos
- Transformaciones reproducibles en pipeline
- Documentación de supuestos y filtros aplicados
Etiquetado
Garantiza la calidad del etiquetado con guías claras, ejemplos, formación de anotadores y controles de consistencia; usa múltiples anotadores y métricas de acuerdo (por ejemplo, kappa) para medir la fiabilidad. Emplea procesos de adjudicación cuando haya discrepancias y considera anotación iterativa (etiquetado activo) para maximizar el valor de las etiquetas. Aprovecha herramientas de anotación que permitan trazabilidad, revisión y exportación controlada de datasets etiquetados.
Validación
Diseña estrategias de validación coherentes con la naturaleza del problema: particiones train/validation/test, cross-validation estratificada para problemas desbalanceados, y validación temporal para series. Evita fugas de datos (data leakage) separando estrictamente conjuntos y usando pipelines que encapsulen transformaciones. Para ajuste de hiperparámetros preferible usar validación anidada o holdout independiente, y emplea early stopping y regularización para controlar overfitting.
Evaluación de modelos
Selecciona métricas alineadas con el objetivo del negocio: accuracy, precision, recall, F1, AUC-ROC, o métricas específicas de ranking/relevancia según el caso. Complementa con matriz de confusión, curvas ROC/PR y evaluación de calibración de probabilidades. Realiza pruebas de robustez en subgrupos, análisis de sesgo y comparaciones frente a baselines, y reporta intervalos de confianza o significancia estadística; finalmente establece métricas y alertas para el monitoreo en producción.
Desafíos éticos, legales y de privacidad al usar datos médicos en medicina personalizada
El uso de datos médicos en la medicina personalizada plantea importantes desafíos éticos relacionados con el respeto a la autonomía del paciente, el consentimiento informado y la equidad en el acceso a tratamientos. El análisis masivo de historiales clínicos y genómicos puede revelar información sensible que afecta no solo al individuo sino a familiares, creando dilemas sobre quién debe decidir el uso de esos datos y cómo evitar discriminación por motivos genéticos, socioeconómicos o de salud. Además, los algoritmos de inteligencia artificial pueden perpetuar sesgos si se entrenan con datos no representativos, lo que compromete la justicia en la atención personalizada.
Desde el punto de vista legal y de privacidad, es crucial garantizar la protección de los datos personales mediante marcos regulatorios, normas de seguridad y mecanismos de responsabilidad claros. Los riesgos incluyen la reidentificación de datos supuestamente anónimos, la transferencia transfronteriza de información y la falta de transparencia en el uso y el intercambio de datos entre instituciones y empresas tecnológicas. Aspectos clave a abordar incluyen:
- Consentimiento y transparencia: informar claramente sobre el uso, duración y finalidad de los datos.
- Seguridad y anonimización: aplicar medidas técnicas y organizativas robustas para minimizar riesgos de filtración.
- Responsabilidad y cumplimiento: definir responsabilidades legales frente a errores, sesgos o violaciones.
En la práctica, superar estos desafíos exige gobernanza multidisciplinaria que combine perspectiva clínica, ética, jurídica y tecnológica, así como la participación activa de pacientes en el diseño de políticas de datos. Es necesario implementar auditorías continuas, estándares de interoperabilidad y estrategias de minimización de datos para limitar la exposición innecesaria, además de promover la explicabilidad de modelos predictivos para mantener la confianza y la rendición de cuentas en la medicina personalizada.