¿Qué instituciones están usando y cómo se entrenan modelos de IA con datos médicos?
Qué instituciones están usando IA en salud: hospitales, universidades, empresas y gobiernos
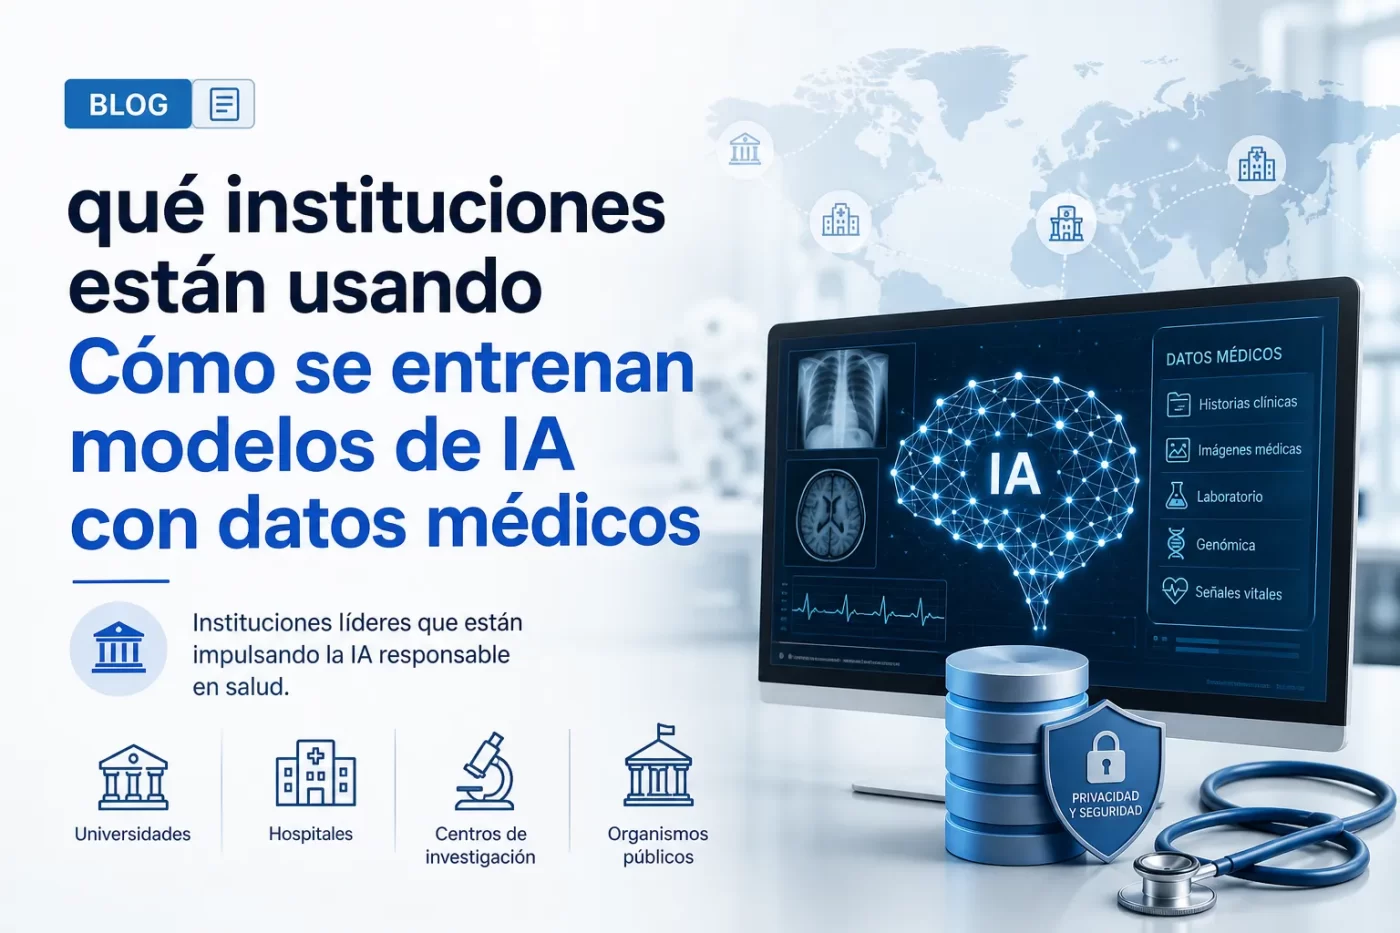
Los hospitales están entre las principales instituciones que implementan IA en salud para apoyar el diagnóstico y la atención clínica, especialmente en áreas como diagnóstico por imagen, triage y monitorización continua de pacientes. La IA se integra con historias clínicas electrónicas para optimizar flujos operativos, reducir tiempos de espera y priorizar recursos, siempre con enfoque en la validación clínica y la seguridad de los datos. Estas aplicaciones buscan mejorar la precisión diagnóstica y la eficiencia hospitalaria sin reemplazar la labor clínica humana.
Las universidades y centros de investigación lideran el desarrollo y la validación de algoritmos, creando modelos predictivos, estudios de cohortes y ensayos clínicos que prueban la eficacia y seguridad de herramientas basadas en IA. Además, forman profesionales y coordinan proyectos multidisciplinares que abordan interoperabilidad, estándares y sesgos algorítmicos, generando evidencia científica necesaria para la adopción responsable en entornos clínicos.
Las empresas privadas y los gobiernos desempeñan roles complementarios: las empresas —desde startups hasta grandes tecnológicas y farmacéuticas— desarrollan productos, dispositivos y plataformas escalables, mientras que los gobiernos establecen políticas, marcos regulatorios y programas de financiación para la implementación a gran escala. Ambos actores deben coordinarse en aspectos clave como protección de datos, regulación, certificación y gobernanza para que la IA en salud sea segura, ética y accesible.
Cómo se entrenan modelos de IA con datos médicos: métodos, algoritmos y flujo de trabajo
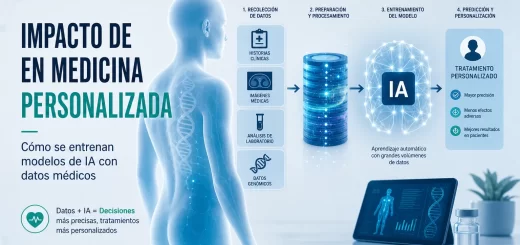
El entrenamiento de modelos de IA con datos médicos comienza por definir el objetivo clínico y seleccionar las fuentes de datos (historias clínicas, imágenes, señales, registros de laboratorio). Es clave garantizar el cumplimiento normativo y la seguridad (anonimización y control de accesos) antes de cualquier uso. El proceso suele dividirse en fases claras: recopilación y curación de datos, anotación y etiquetado, diseño de modelos, entrenamiento y validación, y finalmente despliegue y monitorización.
Preprocesamiento y anotación
El preprocesamiento incluye limpieza, normalización, balanceo de clases y, cuando procede, aumento de datos; la anotación requiere equipos clínicos y protocolos de consenso para asegurar calidad. Ejemplos de tareas repetidas en esta fase:
- Desidentificación y control de acceso.
- Normalización de formatos y unidades.
- Anotación por expertos y validación inter-observador.
- Aumento y etiquetado semiautomático para datos escasos.
En cuanto a métodos y algoritmos, para imágenes médicas y señales se emplean frecuentemente redes neuronales convolucionales (CNN), mientras que para series temporales y texto clínico son habituales RNN/Transformers y modelos de lenguaje. También se utilizan métodos clásicos (bosques aleatorios, gradient boosting) para problemas con características estructuradas. Para proteger la privacidad y aprovechar datos distribuidos aparecen enfoques como el aprendizaje federado y la privacidad diferencial, que forman parte del diseño experimental cuando los datos no pueden centralizarse.
El flujo de trabajo de entrenamiento incluye selección de arquitectura, división de datos (entrenamiento/validación/test), ajuste de hiperparámetros y evaluación con métricas relevantes (por ejemplo, AUC-ROC, sensibilidad, especificidad, precisión según el caso de uso). Las pruebas deben incluir validación cruzada, validación externa y evaluación clínica prospectiva cuando sea necesario; finalmente, el despliegue requiere monitorización continua del rendimiento y planes de actualización para mitigar deriva de datos y riesgos clínicos.
Qué tipos de datos usan las instituciones (EHR, imágenes médicas, genómica) y cómo se preparan
Las instituciones usan principalmente tres tipos de datos clínicos: historias clínicas electrónicas (EHR) que incluyen datos estructurados (diagnósticos, medicamentos, resultados de laboratorio) y texto no estructurado (notas clínicas), imágenes médicas (DICOM de TC, RM, radiografía, ecografía) y datos genómicos (lecturas crudas, alineamientos y variantes). Cada tipo requiere procesos específicos de preparación para que sean útiles en proyectos de investigación, análisis estadístico o modelos de IA, manteniendo cumplimiento legal y calidad científica.
En el caso de las EHR, la preparación incluye procesos de ETL para extraer, transformar y cargar datos; mapeo a estándares terminológicos como ICD, SNOMED o LOINC; limpieza y normalización de valores (fechas, unidades, codificación); y técnicas de anonimización o desidentificación para proteger la privacidad. Para el texto clínico se realizan tareas de NLP: tokenización, normalización de entidades (medicamentos, síntomas), y etiquetado de eventos clínicos, además de control de calidad para detectar registros incompletos o inconsistentes.
Las imágenes médicas se preparan partiendo de ficheros DICOM y pasando por pasos como conversión y armonización entre protocolos, corrección de artefactos, normalización de intensidad, remuestreo espacial y, cuando procede, segmentación y anotación por radiólogos. Estos pasos facilitan comparabilidad entre estudios, permiten la generación de máscaras de interés anatómico y estabilizan las entradas para algoritmos de aprendizaje automático, siempre aplicando controles de calidad y desidentificación de metadatos.
Formatos y pasos comunes
- EHR: CSV/HL7/FHIR para intercambios; mapeo terminológico, limpieza y anonimización.
- Imágenes: DICOM; conversión, normalización de intensidad, remuestreo, segmentación/etiquetado.
- Genómica: FASTQ → BAM/CRAM → VCF; control de calidad, alineamiento, llamado y anotación de variantes.
- Transversales: control de calidad, armonización entre centros, documentación de metadatos y gobernanza de datos.
Protección de la privacidad y cumplimiento: anonimización, aprendizaje federado y normativa
La protección de la privacidad en proyectos de datos y modelos de IA combina técnicas técnicas y prácticas organizativas para reducir riesgos sin perder utilidad. Estrategias como la anonimización y la pseudonimización buscan eliminar o transformar identificadores directos; el aprendizaje federado permite entrenar modelos sin centralizar datos sensibles, manteniendo la información local en los dispositivos o servidores de origen. Integrar estas soluciones desde el diseño favorece el principio de minimización de datos y reduce la superficie de exposición frente a accesos no autorizados.
Medidas recomendadas
- Anonimización y pseudonimización: aplicar técnicas que impidan la reidentificación, documentando los límites de eficacia y la pérdida de calidad de datos.
- Aprendizaje federado y agregación segura: utilizar enfoques que compartan solo actualizaciones o parámetros agregados, combinados con privacidad diferencial cuando sea posible.
- Controles técnicos y organizativos: cifrado en tránsito y reposo, control de accesos, auditorías y registro de operaciones para rastrear uso de datos.
- Políticas de gobernanza: definir roles, responsabilidades y procesos de respuesta ante incidencias y solicitudes de interesados.
El cumplimiento normativo exige alinear estas medidas con marcos legales de protección de datos (por ejemplo, GDPR en la UE o normativas locales equivalentes), incluyendo la realización de evaluaciones de impacto sobre la protección de datos (DPIA) cuando proceda, la firma de acuerdos de tratamiento y la garantía de derechos de acceso, rectificación y supresión. La documentación, la transparencia frente a los titulares y las pruebas periódicas de seguridad y privacidad son imprescindibles para demostrar cumplimiento y mitigar riesgos legales y reputacionales.
Casos prácticos: ejemplos de instituciones que ya entrenan modelos de IA con datos médicos y resultados
Muchas instituciones académicas, hospitales y equipos industriales ya entrenan modelos de IA con datos médicos y han publicado sus resultados en revistas revisadas por pares y repositorios públicos. Estos esfuerzos abarcan desde modelos de imagen médica y segmentación hasta predicción clínica a partir de historias electrónicas y señales fisiológicas, usando tanto datos internos como bases de datos abiertas para entrenamiento y validación.
Ejemplos representativos
- MIT / Beth Israel Deaconess (MIMIC): el conjunto de datos MIMIC y MIMIC-CXR, mantenidos por el MIT en colaboración con BIDMC, se usan ampliamente para entrenar modelos de predicción clínica y extracción de información.
- Stanford Medicine: grupos de Stanford han desarrollado y publicado modelos y conjuntos de datos para interpretación de radiografías torácicas (por ejemplo, CheXpert/CheXNet) y otras aplicaciones de imagen.
- DeepMind & Moorfields Eye Hospital: colaboración conocida por entrenar modelos en OCT y publicar resultados sobre detección y clasificación de patologías retinianas.
- Google Health y centros académicos: Google Health ha publicado estudios colaborativos en áreas como retinopatía diabética y cribado mamográfico con datos clínicos y de imagen procedentes de socios académicos y sanitarios.
- Grandes sistemas sanitarios (Mayo Clinic, Cleveland Clinic, Kaiser Permanente): estos centros disponen de programas de investigación en IA que entrenan modelos con EHR, patología y datos de imagen, y publican sus hallazgos.
Estos proyectos suelen acompañar sus modelos con resultados cuantificados (métricas de rendimiento y validaciones internas o externas) y con publicaciones que detallan metodología, cohortes y limitaciones; por eso constituyen casos prácticos útiles para entender cómo se implementa y evalúa la IA con datos médicos en entornos reales.